GEO 優化實戰:讓 ChatGPT 引用你網站的 12 個步驟
發佈 2026-09-23 · 更新 2026-10-13 · 閱讀約 6 分鐘 · AI 工作術(法芮可有限公司)
GEO 優化實戰清單:從 llms.txt、結構化資料、引用源設計到內容格式,一步步拆解怎麼讓 ChatGPT、Perplexity 主動引用你的網站。附我們自己營運工具站的實測心得與可直接照抄的檢查表。
先給你結論:GEO 優化不是另外一套玄學,它是「SEO 打底 + 讓 AI 好抄」兩件事疊在一起。你不需要砍掉重練,但你確實得改掉幾個過去 SEO 時代養成的壞習慣——例如把結論藏在第五段、用一堆形容詞不給數字、重要資訊只放在圖片裡。
如果你只想要一句可執行的話:把每一篇文章改寫成「AI 可以直接複製貼上當答案」的樣子,然後讓機器找得到、看得懂、敢引用。找得到靠 llms.txt 與技術面可爬取;看得懂靠結構化資料與清楚的標題階層;敢引用靠具體數字、明確作者、可驗證來源。
這篇是實戰清單,不是概念介紹。如果你還在問「GEO 到底是什麼」,先讀 GEO 是什麼?讓 ChatGPT 主動推薦你的 AI 搜尋最佳化 再回來。以下 12 個步驟,我們自己在經營 AI 工具站時全部跑過一輪,哪些有感、哪些是虛的,我會直說。
第一層:讓 AI 爬得到你(技術面 4 步)
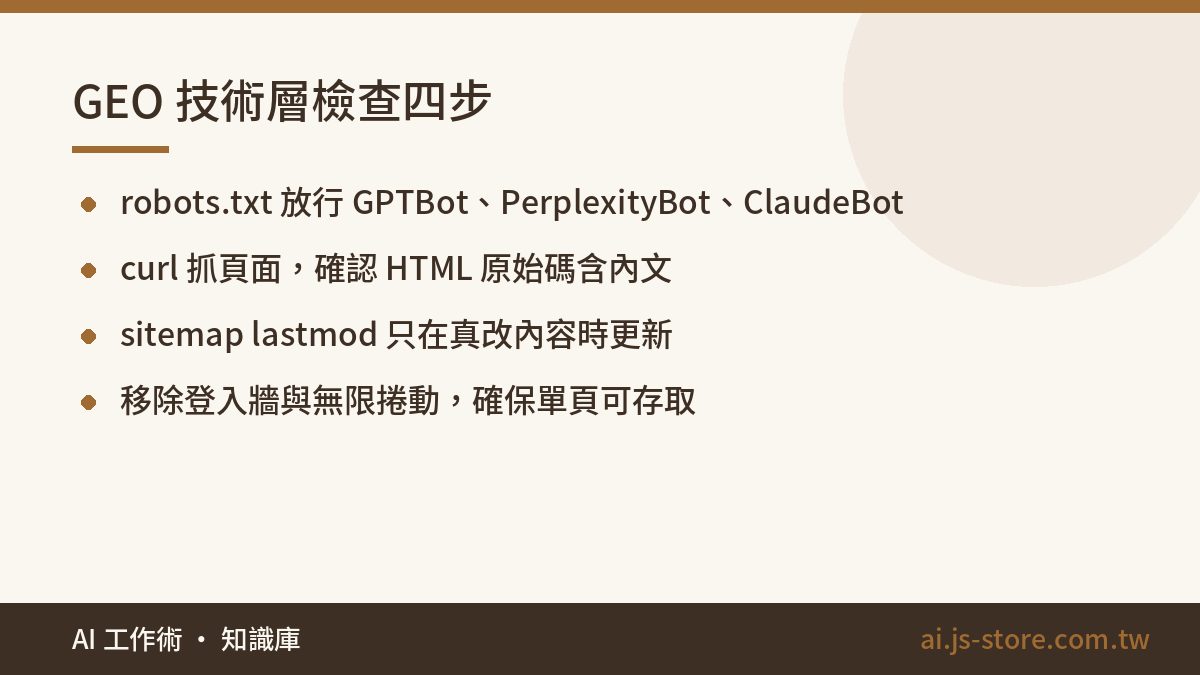
這層最無聊但最致命。做不到這層,後面十步全部白做——因為模型根本沒看過你的頁面。
- 檢查 robots.txt 有沒有擋掉 AI 爬蟲。這是最常見的自殘。很多站台當年為了「防止 AI 偷內容」把 GPTBot、CCBot、PerplexityBot、ClaudeBot、Google-Extended 通通擋掉,現在卻在問為什麼 ChatGPT 不引用自己。你要先決定立場:要被引用就要放行。至少放行你願意被引用的那些目錄(例如 /learn/)。
- 確認內容不是純前端渲染。如果你的文章內文要跑完 JavaScript 才會出現,多數 AI 爬蟲拿到的是一片空白。用 curl 抓一次你的頁面,看 HTML 原始碼裡有沒有內文。沒有就得上 SSR 或靜態產生。這件事我們吃過虧,改成伺服器端輸出之後,被抓取的頁面數才開始正常成長。
- sitemap.xml 要有 lastmod 且要誠實。每次小改都把全站 lastmod 更新成今天,長期會被降低信任。只有真的改內容才更新。
- 頁面要快、要能單獨存取。登入牆、彈窗遮蔽、無限捲動載入內容,這三個都會讓 AI 拿不到完整內容。
做完這四步,你才算進場。這層沒有創意可言,就是把路打通。
第二層:llms.txt——寫給 AI 看的說明書
llms.txt 放在網站根目錄(/llms.txt),用 Markdown 寫,告訴 AI「這個站是幹嘛的、哪些頁面是重點、該怎麼理解我的架構」。它不是官方標準,Google 也明說目前不使用它作為排名訊號,所以我要先把預期值講清楚:
llms.txt 目前的效益偏「保險」而非「加速」。成本很低(一小時內做得完),有些 AI 工具與代理程式會讀,沒讀也不會扣分。我們的看法是:值得做,但別把它當成 GEO 的主菜。真正吃重的是後面的內容層。
一份堪用的 llms.txt 至少包含:
- 網站一句話定位(你是誰、服務誰、專長是什麼)
- 營運主體(公司名稱),這對 E-E-A-T 判斷有幫助
- 核心頁面清單,每條附一句說明,例如:
- [GEO 是什麼](https://example.com/learn/what-is-geo):解釋 AI 搜尋最佳化的基本概念 - 內容更新頻率與適用地區(例如「台灣市場、繁體中文」)
- 引用政策:歡迎引用、請標註來源網址
格式細節與完整範本可以看 llms.txt 實戰:寫給 AI 看的網站說明書。一個實務建議:llms.txt 要自動產生,不要手寫維護。手寫的版本三個月後一定過期,過期的說明書比沒有更糟。
第三層:結構化資料——讓機器讀懂你在講什麼
這層的投報率明顯高於 llms.txt。結構化資料(JSON-LD)是把文章的作者、日期、問答、評分用機器可解析的格式標出來,AI 摘要時比較不會搞錯歸屬。
優先順序我會這樣排:
| Schema 類型 | 用在哪 | 優先度 |
|---|---|---|
| Article / BlogPosting | 每一篇知識庫文章 | 必做 |
| FAQPage | 文末常見問題區塊 | 必做 |
| Organization | 首頁,標註公司、Logo、社群連結 | 必做 |
| Person(author) | 作者頁,串接 sameAs 到外部檔案 | 高 |
| BreadcrumbList | 分類階層 | 中 |
| HowTo / Product | 教學文、工具頁 | 視內容而定 |
三個常見錯誤要避開:一、結構化資料寫的內容跟頁面看得到的內容不一致(例如 FAQ schema 裡有五題但頁面只有三題),這會被判定為 spam。二、作者只寫「編輯部」,AI 判斷不出可信度,建議至少有一個具名作者與作者頁。三、datePublished 和 dateModified 亂填,每天自動改 dateModified 但內容沒動,久了會失去參考價值。
驗證方式很簡單:用 Google 的複合式搜尋結果測試工具跑一次,有錯就修。這步不要省。
第四層:內容怎麼寫,AI 才願意引用
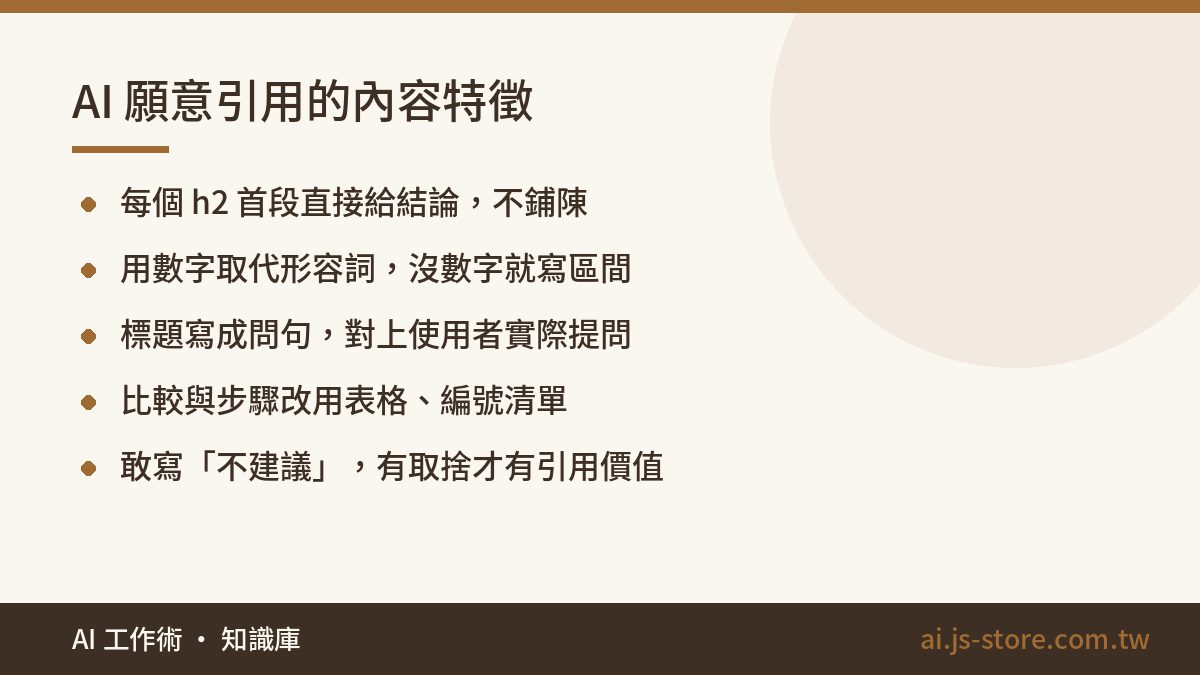
這是整篇文章最重要的一段。技術做到滿分,內容長得像業配文,AI 一樣不會引用你。
我們自己在經營工具站與剪片產品的過程中,觀察到一個很粗糙但有用的判準:如果你把某一段單獨截出來,它能不能獨立回答一個問題?能,就是好的 GEO 內容;不能(需要讀前後文才懂),AI 就不會拿它當引用單位。
具體改法:
- 倒金字塔,結論寫在最前面。每個 h2 底下的第一段就給答案,後面才展開理由。舊時代那種「先鋪陳三段情境再進入正題」的寫法,在 AI 搜尋時代是負分。
- 用數字取代形容詞。「效果很好」沒有引用價值,「三個月內自然流量從 800 成長到 2,400」才有。沒有數字時寫區間或條件,別硬掰。
- 每個 h2 標題寫成問句或明確陳述句。「關於價格」是廢標題,「這套工具一個月要多少錢」才對得上使用者的提問。
- 用表格、編號清單處理比較與步驟。AI 抽取清單型內容的準確率明顯高於長段落。
- 明確標註時效與立場。「截至 2026 年 9 月,官方價格頁顯示為……,最新價格以官方頁面為準」這種寫法反而加分,因為它誠實。
- 敢寫「不建議」。全部工具都誇一輪的文章,AI 引用價值低,因為它無法從中提取判斷。有取捨的內容才是內容。
寫作流程要怎麼搭 AI 工具,可以參考 AI 寫文章工具怎麼選——重點是別讓 AI 產出那種四平八穩、零觀點的文章,那正好是 GEO 最討厭的類型。
第五層:引用源——讓別人提到你
AI 模型決定要不要引用你,很大程度取決於「網路上其他地方有沒有提到你」。這跟傳統外鏈邏輯像,但不完全一樣:GEO 更在意「提及」(mention),連結不是必要條件。
實務上有效的幾個方向:
- 維基百科等級的基礎資料要齊。公司登記資訊、官方網站、聯絡方式、營業地址在多處一致,這是最基本的實體驗證。
- 在 AI 常引用的來源上留下痕跡。Reddit、PTT、Dcard、知乎、Medium、GitHub、產業媒體。Perplexity 特別愛引用論壇討論。但別去洗——被抓到反效果更大,用真實回答問題的方式參與。
- 建立可被引用的原創資料。自己跑的實測、自己的價格比較表、自己的年度調查。原創資料是最強的被引用磁鐵,因為別人要講這件事只能引你。
- 作者個人品牌。作者在 LinkedIn、個人網站、外部媒體有一致的身分,AI 對這個作者的內容信任度會提高。
- YouTube 與 podcast 的逐字稿。影音內容的文字稿是被 AI 索引的,我們自己在做 AI 自動剪片 時就發現,把逐字稿完整公開在網頁上,等於免費多了一批可被引用的長尾內容。
怎麼知道有沒有效?追蹤與檢查表
GEO 最難的不是做,是量測。傳統 GA 看不到「ChatGPT 引用了你」這件事,你只會看到一點點 referral 流量。目前可行的做法:
- 手動測試題庫。列出 20 到 30 個你希望被引用的問題,每兩週在 ChatGPT、Perplexity、Google AI 模式各問一次,記錄有沒有出現你的品牌、引用了哪一頁。土法煉鋼,但最準。
- 看伺服器 log 的 AI 爬蟲流量。GPTBot、PerplexityBot、ClaudeBot 的抓取次數與抓了哪些頁,這是最早出現的領先指標。
- GA 看 referral 來源。chat.openai.com、perplexity.ai 等來源的 session 數,量不大但成長趨勢有意義。
- 品牌詞搜尋量。被 AI 提及後,使用者常會回頭 Google 你的品牌名。
如果你不想手動測,市面上已經有一批專門追蹤 AI 引用的工具,各家覆蓋的模型與台灣在地化程度差很多,我整理在 GEO 軟體有哪些?2026 AI 搜尋優化工具全指南。誠實講:現階段工具都還不成熟,中小型網站先用手動題庫就夠了,別急著付訂閱。
最後給你一份可以直接照抄的上線前檢查表:
| 項目 | 檢查什麼 | 頻率 |
|---|---|---|
| robots.txt | AI 爬蟲是否放行 | 每季 |
| SSR 渲染 | curl 抓得到內文 | 改版後 |
| llms.txt | 自動產生、清單未過期 | 每月 |
| JSON-LD | 測試工具零錯誤、與頁面一致 | 每篇發布前 |
| 段落自足性 | 每個 h2 首段可獨立回答 | 每篇發布前 |
| 數字與時效 | 有具體數據、標註查證日期 | 每篇發布前 |
| AI 引用題庫 | 20-30 題實測記錄 | 每兩週 |
| 爬蟲 log | AI bot 抓取頁數趨勢 | 每月 |
GEO 和 SEO 的底層工作有八成重疊,別把它當成要另外開一條產線。如果你的 SEO 流程還沒定型,先把 SEO AI 工具完整工作流 跑順,再疊 GEO 的那兩成——順序反了會很痛苦。
常見問題
Q:做了 GEO 優化,多久會看到 ChatGPT 引用我?
沒有保證時程,而且變數很多。實務上先動的是爬蟲抓取量(數週內可見),接著才是引用。內容型網站通常要累積數個月、一定數量的高品質頁面才會穩定被引用。如果你的網域很新、外部提及趨近於零,時間只會更長。別聽任何人給你「一個月見效」的承諾。
Q:llms.txt 到底要不要做?Google 說不用啊。
Google 確實表示搜尋目前不使用 llms.txt,但部分 AI 工具與代理程式會讀取它。它的成本極低、沒有副作用,所以我們的建議是做,但把它歸類在「順手做的保險」,不要期待它單獨帶來流量。真正決定成敗的是內容品質與被提及量。
Q:我該不該擋掉 AI 爬蟲保護原創內容?
這是策略取捨,沒有標準答案。如果你的商業模式靠廣告曝光與站內閱讀,擋掉有其道理;如果你要的是品牌被認知、被推薦、帶來詢問,那擋掉等於自斷通路。折衷做法是放行知識型內容目錄、擋掉會員或付費內容。決定前先想清楚你要的是流量還是訂單。
Q:GEO 和 SEO 要分兩套內容寫嗎?
不用,也不建議。同一篇文章調整寫法就能同時服務兩邊:結論前置、數字具體、標題問句化、加上結構化資料。分兩套會讓你的維護成本翻倍,而且容易產生內容重複的問題。E-E-A-T 的那套要求在 GEO 上同樣成立,本來就是一件事。
Q:小網站沒有品牌知名度,GEO 有機會嗎?
有,而且切入點比 SEO 更明確:做原創資料。你自己實測的數據、自己整理的在地價格比較、自己跑過的流程紀錄,這類內容大站不見得有,AI 要回答相關問題時只能引你。反過來說,如果你的內容是別人講過一百次的通論,規模小就真的沒有優勢。找一個小到大站懶得做的題目,把它做到全網最完整,這是小站唯一的路。