中文自動字幕準確率實測:從 82.6% 到 94.8%
發佈 2026-10-19 · 更新 2026-10-18 · 閱讀約 7 分鐘 · AI 工作術(法芮可有限公司)
中文自動字幕準確率實測:我們用三支真實口播片,跟人工黃金稿逐行比對。只用一個辨識模型,字幕行正確率是 82.6%;改成 Breeze-ASR-25+large-v3-turbo 對照+Claude 校對後,拉到 94.8%。這篇說明怎麼量、哪些做法有效、哪些做法沒用,以及剩下的錯出在哪裡。
先講結論:台灣口播片如果只丟給一個語音辨識模型,字幕大約每 6 行就有 1 行要改;改成「兩個模型互相對照+AI 校對」,可以降到大約每 20 行改 1 行。我們在 2026-09-28、29 兩天,用三支真實口播片跟人工黃金稿逐行比對。單一辨識模型的「字幕行完全正確率」是 82.6%;換成 Breeze-ASR-25 主辨識+large-v3-turbo 對照+Claude 校對之後,提高到 94.8%,字元正確率是 98.9%。
這篇講四件事:我們怎麼量(工具常說的準確率,跟你實際要改幾行是兩回事)、哪個步驟真正拉開差距、哪些做法看起來合理卻沒用,以及剩下那 5% 的錯出在哪裡。如果你正在評估自動字幕工具,或想自己串一套流程,這些數字可以直接拿來當基準。
先說限制:樣本只有三支片,數字只代表這組素材的結果,不是任何工具的官方保證。影片是客戶的,文中不會放任何原句。
怎麼量:一行「一個字都不差」才算對
三支測試片刻意挑了不同難度:
- 6 分鐘口播:典型的知識型長口播,最接近多數人拍的內容。
- 58 秒短片:短影音長度,節奏比較快。
- 吵雜餐廳雙人:有環境噪音,加上兩個人對話,刻意挑難的。
每支片都先由人工逐字聽打、校對成黃金稿,當作標準答案,再用兩種口徑比對:
| 指標 | 怎麼算 | 代表什麼 |
|---|---|---|
| 字幕行完全正確率 | 自動字幕的某一行,要跟黃金稿對應的那一行一個字都不差才算對;錯一個同音字、漏一個字或多一個字,整行都算錯 | 你剪片時要停下來改幾次 |
| 字元正確率 | 以「字」為單位,算對了多少比例 | 多數工具宣稱「準確率」時常用的口徑 |
我們自己營運剪片產品,在意的是使用者拿到字幕後還要動幾次手,所以堅持用「行」來量。剪片的人改字幕是一行一行改的。字元正確率 98.9% 聽起來像是不用改,但錯字會分散在不同行,只要一行有錯,你就得停下來聽一次、改一次。行正確率才會直接對應到你要花的時間。下次看到工具標榜「準確率 9X%」,先問一句:算的是字,還是行?
實測結果:從 82.6% 拉到 94.8%
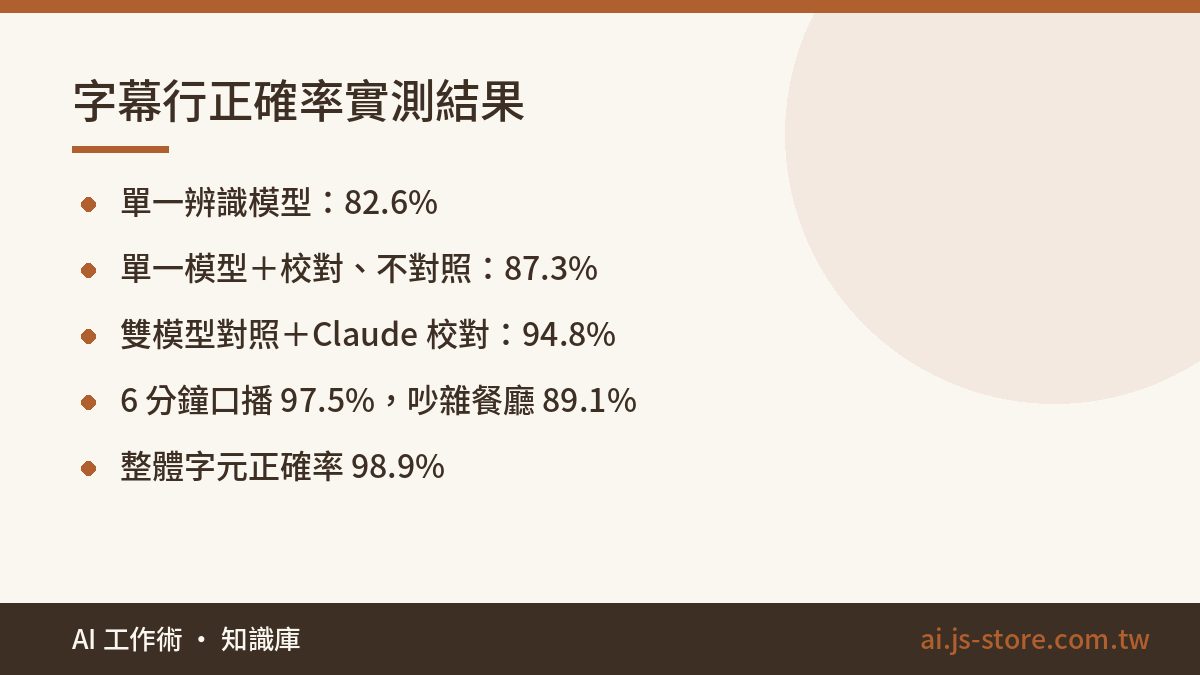
| 做法 | 字幕行完全正確率 |
|---|---|
| 單一辨識模型 | 82.6% |
| 單一模型+校對,不做第二模型對照 | 87.3% |
| Breeze-ASR-25 主辨識+large-v3-turbo 對照+Claude 校對 | 94.8% |
最終流程拆到單支片來看:
- 6 分鐘口播:97.5%,大約每 40 行才有 1 行要改。
- 吵雜餐廳雙人:89.1%,大約每 9 行就有 1 行要改。
- 三支整體的字元正確率:98.9%。
有兩個重點。第一,真正拉開差距的是「對照」這一步:同樣有校對,不對照只到 87.3%,加上第二個模型對照才到 94.8%。第二,收音環境的影響比換模型還大:同一套流程,長口播和吵雜餐廳差了 8 個百分點以上。如果你的片大多在戶外或店裡收音,與其換工具,不如先換一支好一點的麥克風。
流程拆解:兩個模型對照+AI 校對怎麼分工
- 主辨識:Breeze-ASR-25。這是聯發創新基地以 Whisper 為基礎、針對台灣華語與中英夾雜調整過的模型。遇到台灣口音、講到一半冒出英文單字的情況,它比通用模型穩,所以由它出主稿。
- 對照:large-v3-turbo。同一段音再跑一次,兩份稿逐段比對。兩個模型的訓練資料和弱點不同,剛好錯成同一個字的機率低,所以兩邊不一致的地方,最可能藏著錯字。
- 校對:Claude。把主稿、對照稿和不一致的段落一起交給 Claude,由它依上下文判斷哪一版對、修掉同音錯字,並要求它不准改寫語氣、不准潤稿。
為什麼「單一模型+校對」只到 87.3%?關鍵在於語言模型聽不到聲音,只看得到文字。如果辨識模型寫出一個「錯但通順」的詞,Claude 沒有任何理由懷疑它。第二個辨識模型提供的,是唯一來自音檔的第二意見,等於在告訴校對者:「這裡兩邊聽到的不一樣,你要看一下。」少了這個訊號,校對只抓得到明顯不通的句子。
校對這一步也有風險:語言模型很容易「好心」把口語改成書面語,或補上講者沒說的字,這就是 AI 幻覺在字幕上的樣子。對做口播的人來說,字幕比自己講的還通順,觀感反而更差,因為那不是他的語氣。所以校對的指示要寫死:只修錯字,不動用詞。
試過但沒用的三件事
這些做法聽起來都很合理,我們也實際試過,最後都拿掉了:
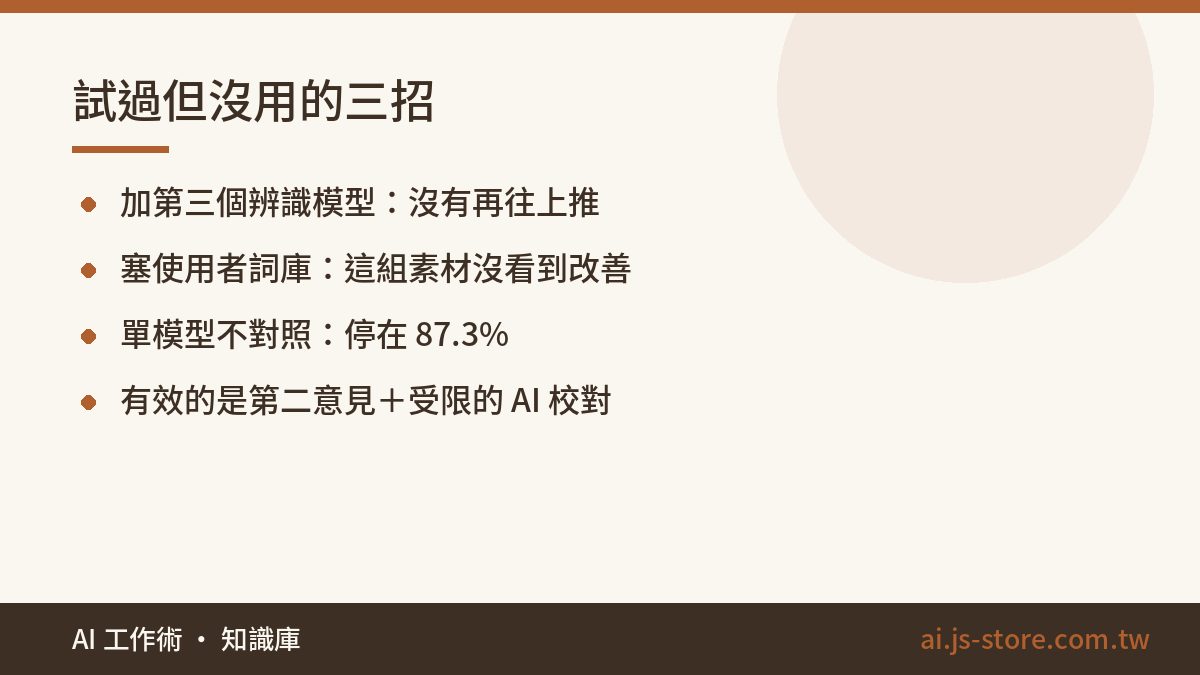
- 加第三個辨識模型:直覺上三個模型投票會更準,實測卻沒有再往上推。我們的推測是:真正難的音,三個模型會一起錯;簡單的音,前兩個早就對了。多一個模型,只是多了運算時間和成本。
- 塞使用者詞庫:先把講者常用的名詞餵給辨識模型,在這組素材上沒看到改善。詞庫還需要人維護,沒效果就不值得留。
- 單模型不對照:只用一個模型出稿,直接交給校對,停在 87.3%。原因上一節講過:校對者聽不到聲音。
整理下來的心得是:不是堆得越多越好,真正有效的只有兩樣:一個獨立的第二意見,加上一個會看上下文、但被限制不准亂改的校對。如果你要自己串流程,先把這兩樣做好,再考慮其他。
剩下 5% 錯在哪:兩種工具救不了的錯
做到 94.8% 之後,剩下的錯幾乎都落在兩類:
- 三個模型都聽不出來的音。像是含糊帶過、吞字、兩人同時講話、背景聲蓋過人聲。這種情況連第三個模型都一起錯,校對者又聽不到聲音,只能照著錯的稿走。吵雜餐廳那支掉到 89.1%,跟這類錯脫不了關係。
- 講者自己的專有名詞。像是品牌名、人名、自創詞、內部代號。辨識模型沒聽過,Claude 也沒看過,只能猜成最常見的同音詞。猜出來的字往往很通順,所以最難一眼看出來。
知道錯在哪裡,人工檢查就能縮小範圍,不用從頭看到尾:
| 你的影片 | 建議做法 |
|---|---|
| 安靜環境的單人口播 | 自動字幕直接用,快速掃一遍專有名詞即可 |
| 有專有名詞的業配、教學 | 上片前用「搜尋取代」把品牌名、人名統一檢查一次 |
| 吵雜環境、多人對話 | 預留時間逐行看,或下次收音改用領夾麥 |
如果你是用剪映、CapCut 這類工具的內建字幕,選工具時可以參考 CapCut 自動字幕替代方案和剪映替代方案台灣怎麼選。不過不管用哪一套,上面這兩類錯都一樣存在,差別只在出現得多頻繁。
最後說明:這套「Breeze-ASR-25 主辨識+large-v3-turbo 對照+Claude 校對」,就是我們 AI 自動剪片免剪自動上字幕在用的流程。你上傳口播片,字幕就直接由這套流程跑出來,剩下要你看的,基本上就是上面那兩類錯。
常見問題
Q:中文自動字幕準確率多少才算夠用?
先看是怎麼量的。用字元算,98.9% 已經很高;但用「一行完全正確」來算,同一批稿只有 94.8%,大約每 20 行要改 1 行,人工掃一遍就能收尾。單一模型的 82.6% 大約每 6 行就要改 1 行,會明顯拖慢你的剪片進度。
Q:為什麼字元正確率 98.9%,字幕還是要改?
因為錯字會分散在不同行。一行只要錯一個字,你就得停下來聽、動手改,所以實際要改幾次,看的是行正確率,不是字元正確率。這也是我們實測時用行來量的原因。
Q:在吵雜環境錄的影片,自動字幕還能用嗎?
能用,但要降低期待。我們吵雜餐廳雙人那支片,用同一套流程只有 89.1%,比長口播的 97.5% 低不少。剩下的錯多半是模型根本聽不清楚的音,換工具幫助有限,改善收音比較實在。
Q:多加幾個辨識模型或匯入詞庫,會不會更準?
這兩種我們都試過,在這組素材上都沒有帶來改善。第三個模型會跟前兩個一起錯在同樣的難音上;詞庫沒看到效果,還要花人力維護。真正有效的是兩個模型對照,加上受限制的 AI 校對。
Q:不想自己串模型,有現成可以用的嗎?
有。我們的 AI 自動剪片就是用本文這套流程上字幕,上傳口播片就會產出字幕,你只需要檢查專有名詞和聽不清楚的段落。