AI 幻覺為什麼會發生?原理與 5 步查證 SOP
發佈 2026-10-10 · 更新 2026-10-13 · 閱讀約 6 分鐘 · AI 工作術(法芮可有限公司)
AI 幻覺為什麼會發生?AI 不是在查資料,而是在猜下一個字。訓練機制又獎勵猜測,所以它會一本正經胡說八道。本文用白話拆解 5 個成因,附高風險內容分級表、團隊實際在用的 5 步查證 SOP,以及降低幻覺的 Prompt 寫法。
AI 幻覺為什麼會發生?一句話:大型語言模型不是在「查資料」,而是在「猜下一個字最可能是什麼」。它讀過海量文字,學會了什麼樣的句子聽起來像正確答案,但它內部沒有「這是真的嗎」的檢查機制。所以它不知道答案時,最自然的反應不是說「我不知道」,而是生出一段通順、篤定、細節齊全的假答案。
更麻煩的是,模型在訓練與評測時,「猜對」會加分,「說不知道」通常拿不到分,久了就養成寧可硬猜的習慣。所以模型升級不會讓幻覺消失,只會讓它變少,也變得更難察覺。
結論先講:幻覺無法根除,只能管理。這篇用白話講清楚它的 5 個成因和哪些內容最危險,再給你一套我們團隊每天在用的 5 步查證 SOP。照做,就能把大部分幻覺擋在發布之前。
AI 幻覺是什麼?不是說謊,是「接龍接得太順」
AI 幻覺(Hallucination)指的是模型產出看起來合理,實際上錯誤或根本不存在的內容。常見的有這幾種:
- 捏造來源:引用不存在的論文、書名、網址、判例。
- 數字張冠李戴:價格、日期、版本號、統計數據講得很精確,卻對不上。
- 功能腦補:說某工具有某個按鈕或設定,實際上沒有。
- 人物混搭:把 A 的經歷安到 B 身上,或替小有名氣的人編一段履歷。
注意,它不是「說謊」。說謊要先知道真相再故意講錯,模型根本沒有真假的概念,它只是在玩一場水準很高的文字接龍。你問「某篇論文的作者是誰」,它會接出「一個像作者的名字」,而不是去資料庫查。
這種錯誤的代價已經很真實:美國就有律師用 ChatGPT 寫訴狀,引用了好幾個根本不存在的判例,最後被法院處罰。AI 講得越篤定,你越要提高警覺,這是用 AI 的第一條基本功。
AI 幻覺為什麼會發生?5 個根本原因
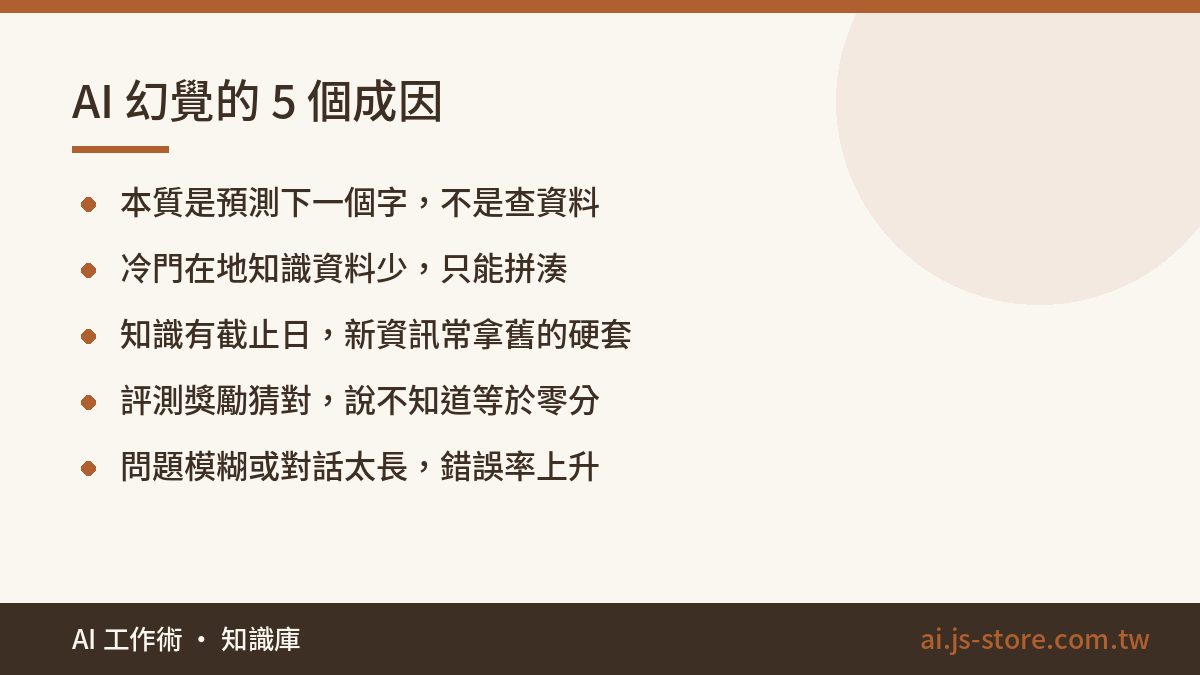
- 本質是機率預測,不是查事實:模型每一步只決定「下一個字接什麼最順」。順不等於對,模型沒看過足夠資料的題目尤其明顯。
- 冷門知識資料太少:熱門事實在訓練資料裡出現過非常多次,模型記得很牢。台灣在地的小品牌、某條地方法規、某間公司的內部規定,出現次數極少,模型只能「拿類似的東西拼」。
- 知識有截止日:模型的訓練資料停在某個時間點,之後的新產品、新價格、新政策它都不知道。它也不一定會告訴你它不知道,常常直接拿舊資料硬套。
- 訓練機制獎勵猜測:OpenAI 研究團隊在 2025 年發表的研究就點出,多數評測只看答對率,回答「不確定」等於零分。這跟考試猜選擇題一樣,猜了還有機會得分,模型因此學會「不會也要寫」。
- 你給的條件太模糊或太長:問題沒講清楚範圍,模型會自己補假設;對話拉太長,前面的資料可能被擠出注意範圍,回答就開始前後矛盾。為什麼聊久會「忘記」,可以看上下文長度是什麼那篇的完整解釋。
把這 5 點連起來就懂了:問題越冷門、越新、要求越精確、對話越長,幻覺機率越高。這不是哪一家模型獨有的問題,ChatGPT、Gemini、Claude 都會發生,只是程度和表現方式不同。
哪些內容最容易出現幻覺?風險分級表
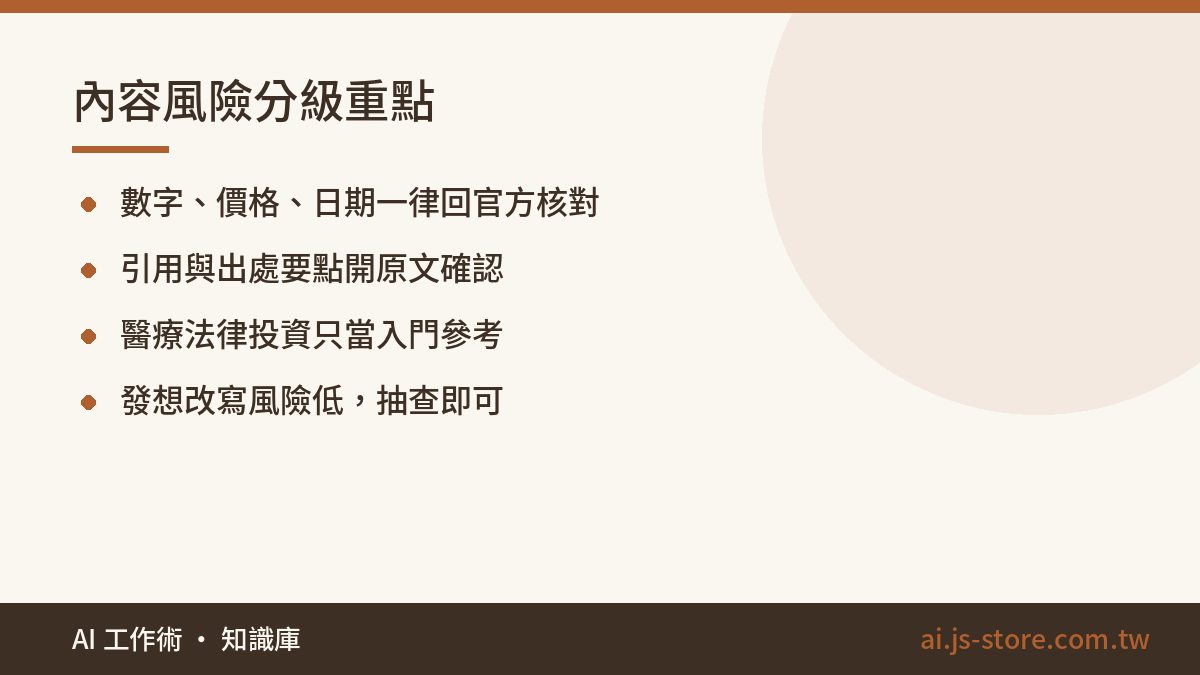
不是每句 AI 回答都要逐字查證,那樣還不如自己寫。重點是分級處理,把查證的力氣花在會出事的地方。
| 風險等級 | 內容類型 | 典型例子 | 處理方式 |
|---|---|---|---|
| 高 | 具體數字、日期、價格、版本號 | 「方案月費 X 元」「某年某月上線」 | 一律回官方來源核對,查不到就刪 |
| 高 | 引用、出處、法規、判例、論文 | 「根據某某研究指出」 | 點開原文,確認存在且內容相符 |
| 高 | 醫療、法律、稅務、投資 | 用藥劑量、合約條文解讀 | 只當入門參考,結論交給專業人士 |
| 中 | 工具功能、操作步驟 | 「在設定裡打開某選項」 | 實際操作一次,確認介面還在 |
| 中 | 人物、公司背景 | 創辦人經歷、公司規模 | 交叉比對 2 個以上獨立來源 |
| 低 | 發想、改寫、摘要你提供的資料 | 標題發想、文案潤稿 | 看順不順,對照原文抽查即可 |
我們自己經營 AI 工具站,整理工具資料時,踩最多雷的就是「價格」和「免費額度」。AI 給的數字常常是舊方案,或把美金和台幣混在一起,偏偏看起來很合理。後來我們的規則很簡單:價格欄位不准由 AI 直接填,一律人工對照官方價格頁,其他描述才讓 AI 起草。
查證 SOP:5 步把幻覺擋在發布前
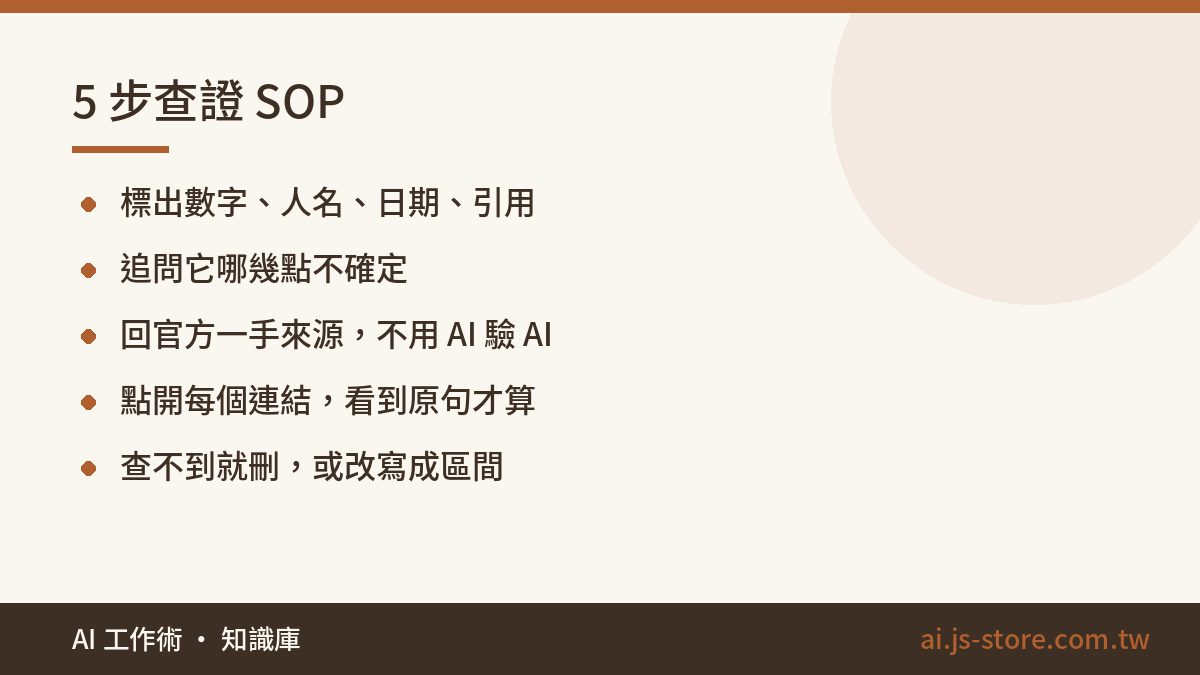
以下是我們團隊發文或寫工具介紹前的固定流程。一篇大約多花 10 到 20 分鐘,但比事後被讀者抓錯、改文、道歉划算太多。
- 標出「可查證的主張」:把回答裡的數字、人名、日期、引用、功能描述全部標起來。這步可以叫 AI 自己做:「把你上面回答中所有可查證的事實列成清單」。
- 問它「你有多確定」:追問「哪幾點你不確定?哪些可能已經過時?」模型的自評不完全可靠,但常會主動說出它其實沒把握的地方,幫你縮小查證範圍。
- 回到一手來源:官方網站、價格頁、說明文件、政府公告、論文原文。不要用另一個 AI 的回答來驗證 AI,兩個模型可能學到同一份錯誤資料。
- 點開每一個連結:AI 給的網址可能是捏造的,也可能真的存在,但內容根本沒講它說的那件事。只確認連結存在不算查證,要看到能支持那句話的原句。
- 查不到就刪,或改寫成區間:查不到的精確數字,改成「以官方公告為準」或只寫範圍;找不到出處的引用,整句拿掉。寧可少一個數字,也不要留一個錯的。
寫給自己看的筆記,做到第 3 步就夠了;要對外發布或交給客戶、主管的東西,5 步都要跑完。
降低幻覺:Prompt 寫法與工具怎麼選
查證是最後一道防線,在那之前還能先把幻覺機率壓低。最有效的 4 個做法:
- 明確允許它說不知道:在問題後面加一句「如果不確定,請直接說不確定,不要猜」。這句話很簡單,但能明顯減少硬掰。想要長期生效,可以寫進自訂指令,寫法參考自訂指令怎麼寫才有效。
- 給它資料,不要叫它回憶:把官方文件、會議紀錄、產品規格貼進去,要求「只根據以上內容回答,沒提到的就說沒提到」。先餵資料再提問,幻覺會比直接問少很多。
- 要求標註出處:請它在每個重點後面註明依據的是哪一段資料,方便你回頭對照。
- 把大問題拆小:一次問十件事,錯誤會混在正確答案裡很難發現;一次問一件,比較好檢查。
工具方面,有聯網搜尋的 AI 確實比較少幻覺,但不是零。Perplexity,或開了搜尋的 ChatGPT、Gemini,都會附上來源。問題是它可能誤讀網頁、抓到過時的頁面,或者引用的來源其實沒支持那句話。兩者的差異我們在Perplexity 與 Google 比較有實測。我們的建議是:查新資訊用有搜尋的 AI,查完照樣點開來源;純發想、改寫用一般模式就好,不需要搜尋。
常見問題
Q:AI 幻覺有辦法完全消除嗎?
目前做不到。只要模型的本質還是預測下一個字,就一定有機率產出錯誤內容。新模型會讓幻覺變少,但錯誤也可能寫得更像真的,所以查證的習慣不能省。
Q:付費版 AI 比免費版更不會幻覺嗎?
較新、較大的模型通常錯誤率較低,付費方案也比較常能用到搜尋與推理功能,但不代表不會錯。不管免費還是付費,高風險內容都要照同一套 SOP 查證。
Q:叫 AI 附上參考資料,就可以相信它了嗎?
不行。AI 可能捏造不存在的網址或書名,也可能附上真的連結但內容對不上。一定要點開原文,看到能支持那句話的原句,才算查證完成。
Q:怎麼判斷一段回答可能是幻覺?
注意這幾個警訊:數字精確到小數點卻沒有出處、引用聽起來很專業卻搜尋不到、冷門問題卻答得特別流暢篤定、追問細節時前後說法不一。遇到這些情況先打個問號,回到一手來源確認。