上下文長度是什麼?AI 聊久會忘記的原因與對策
發佈 2026-10-06 · 更新 2026-10-13 · 閱讀約 6 分鐘 · AI 工作術(法芮可有限公司)
Context window(上下文長度)就是 AI 一次能看見的文字總量。本文用白話解釋 token 怎麼算、為什麼還沒到上限 AI 就開始忘,附症狀對照表、交接摘要 Prompt 與 6 個實用對策,讓你知道什麼時候該開新對話、規則該放哪裡。
AI 聊到第三十輪,突然忘了你一開始交代的語氣,還把早就否決的方案又端出來。這不是它變笨,而是撞到了上下文長度(context window)的上限,或者已經接近上限、注意力開始被稀釋。簡單說,context window 就是 AI 一次能「看見」的文字總量。你的提問、它的回答、你上傳的檔案和系統指令,全部加在一起算。
它不是長期記憶,比較像一張辦公桌:桌面就那麼大,新文件放上來,舊文件就得收進抽屜,或直接丟掉。超過上限時,聊天產品通常會截掉或壓縮最早的內容,所以最先被忘記的,往往就是你最早講、也最重要的那幾條規則。
這篇用白話把 context window 講清楚:token 怎麼算、為什麼還沒到上限也會忘,以及我們自己營運 AI 產品時實際在用的 6 個對策。看完你會知道什麼時候該開新對話,什麼東西該放在哪裡。
Context window 是什麼?用「辦公桌」來理解
先破除一個誤會:AI 模型本身不會記住你的對話。每次你按下送出,系統會把到目前為止的整段對話重新打包,送給模型從頭讀一遍,模型再接著往下寫。所以它「記得」前面講過什麼,其實是每一輪都在「重讀」。
這個包裹最多能裝多少,就是 context window。會佔掉這張桌面的東西包括:
- 系統指令與自訂指令:你設定的角色、口吻、格式要求,每一輪都會帶上。
- 整段歷史對話:AI 的回答也算,而且通常比你的問題長得多。
- 上傳的檔案與貼上的長文:一份 PDF 可能一口氣吃掉一大塊。
- 工具執行結果:網頁搜尋結果、程式執行輸出,在 AI Agent 跑長任務時特別吃容量。
另外,它跟聊天產品的「記憶功能」是兩回事。跨對話記憶比較像 AI 另外幫你存的一本小筆記,下次開新對話時再挑幾條塞進上下文,容量很小,只會記摘要,記不了細節。
Token 怎麼算?中文比英文更吃容量嗎
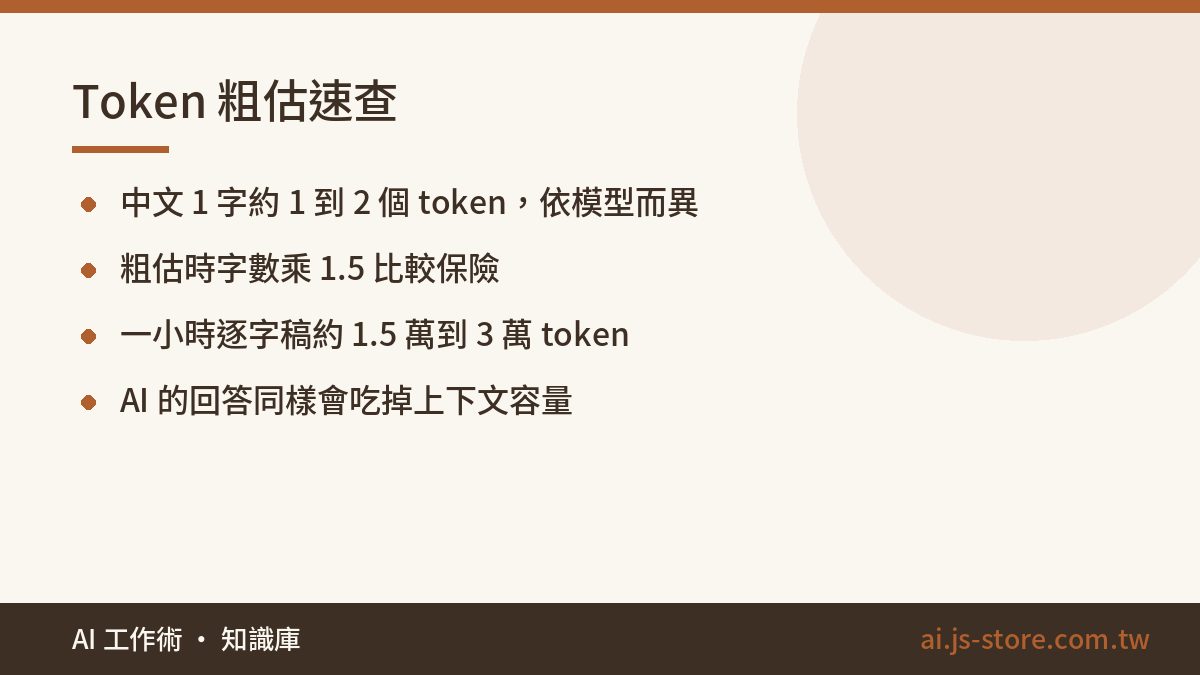
上下文長度的單位是 token,也就是模型切字的最小單位。英文一個常見單字大約 1 個 token;中文一個字通常落在 1 到 2 個 token 之間,實際數字依各家模型的切字方式而定。粗估時,把中文字數乘以 1.5,抓個保險的上限就夠用了。
| 內容類型 | 大約字數 | 粗估 token |
|---|---|---|
| 一則很長的 LINE 訊息 | 約 200 字 | 200 到 400 |
| 一篇部落格文章 | 約 3,000 字 | 3,000 到 6,000 |
| 一小時演講逐字稿 | 約 1 萬到 1.5 萬字 | 1.5 萬到 3 萬 |
| 一本中文書 | 約 10 萬到 20 萬字 | 10 萬到 40 萬 |
目前主流模型的上下文長度,從十幾萬到上百萬 token 都有。同一家的不同方案、不同模型也可能不一樣,而且調整得很頻繁,實際數字以官方規格頁為準。免費版和付費版在用量、模型上的差別,可以看 ChatGPT 免費與付費差別。
看起來很大對吧?但別忘了,每一輪的回答都會累積上去,再加上你中途貼的幾份文件,長對話其實很快就會變得很肥。
為什麼還沒到上限,AI 就開始忘?
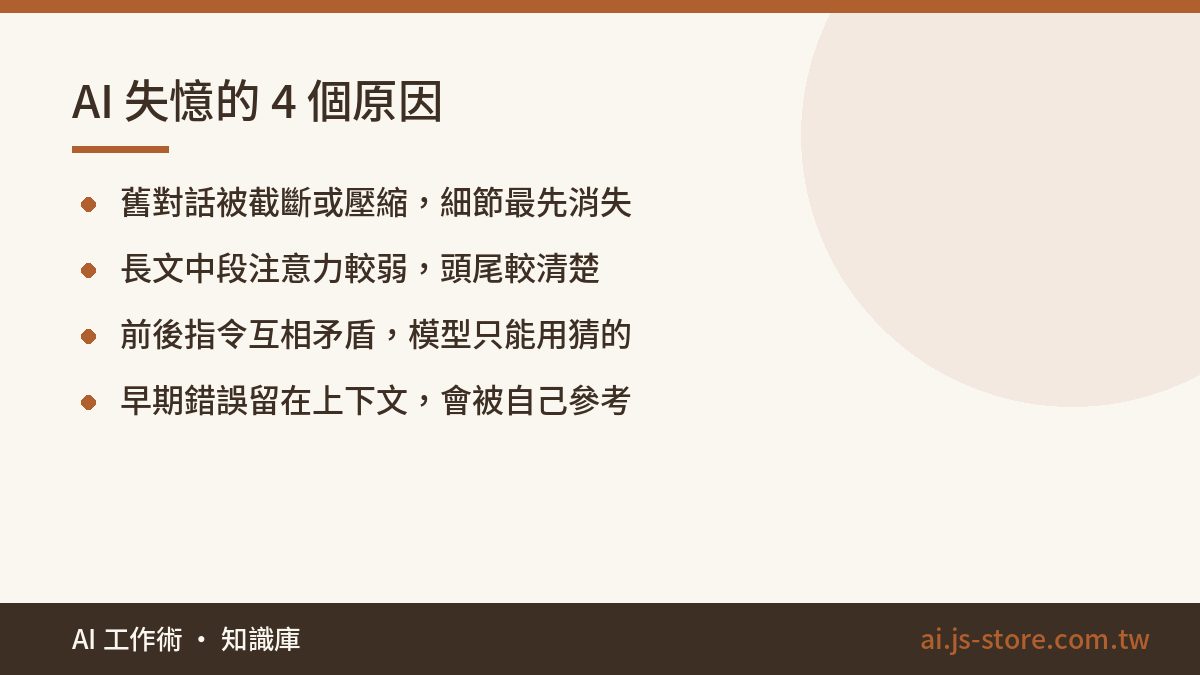
很多人以為只要沒超過上限就不會忘,實際上「失憶」常常比上限更早出現,主要有四個原因:
- 被截斷或被壓縮:聊天產品為了速度和成本,可能在你看不到的地方把舊對話壓成摘要。數字、專有名詞,還有「不要做什麼」這類細節,最容易在摘要裡消失。
- 中間遺忘(lost in the middle):研究發現,模型對長文本開頭和結尾的資訊比較敏感,夾在中間的段落比較容易被忽略。上下文越長,這個現象越明顯。
- 指令互相打架:第 3 輪你說「用條列」,第 15 輪又說「寫成段落」,模型只能猜你現在要哪一種。長對話裡累積的矛盾指令,比上限更常造成「它不聽話」。
- 錯誤自我強化:AI 早先答錯的內容也還在上下文裡,它會參考自己的錯誤,越修越歪。
中間遺忘這件事,我們是在自己的產品上親身踩到的。做 AI 自動剪片引擎初期,我們把整支長影片的逐字稿一次丟給模型挑精華片段,結果被挑中的段落明顯集中在開頭和結尾,中段的好內容常被跳過。後來改成按段落切塊、每塊各自評分再彙整,選段分布才變平均。模型「看得到」全部,不代表它「同樣注意」全部。
| 你看到的症狀 | 可能原因 | 對策 |
|---|---|---|
| 忘了一開始交代的語氣或格式 | 早期指令被截斷或稀釋 | 規則放進自訂指令,或在新對話開頭重貼 |
| 已否決的方案又被提出來 | 摘要時「不要」類資訊遺失 | 維護一份「已決定清單」 |
| 長文件中段的內容問不到 | 中間遺忘 | 分段處理,指名段落提問 |
| 回覆越來越慢、品質下滑 | 上下文接近飽和 | 寫交接摘要,開新對話 |
| 一直犯同一個錯 | 錯誤留在上下文裡 | 編輯原提問重來,不要疊加糾正 |
6 個實用對策:讓長對話不失憶
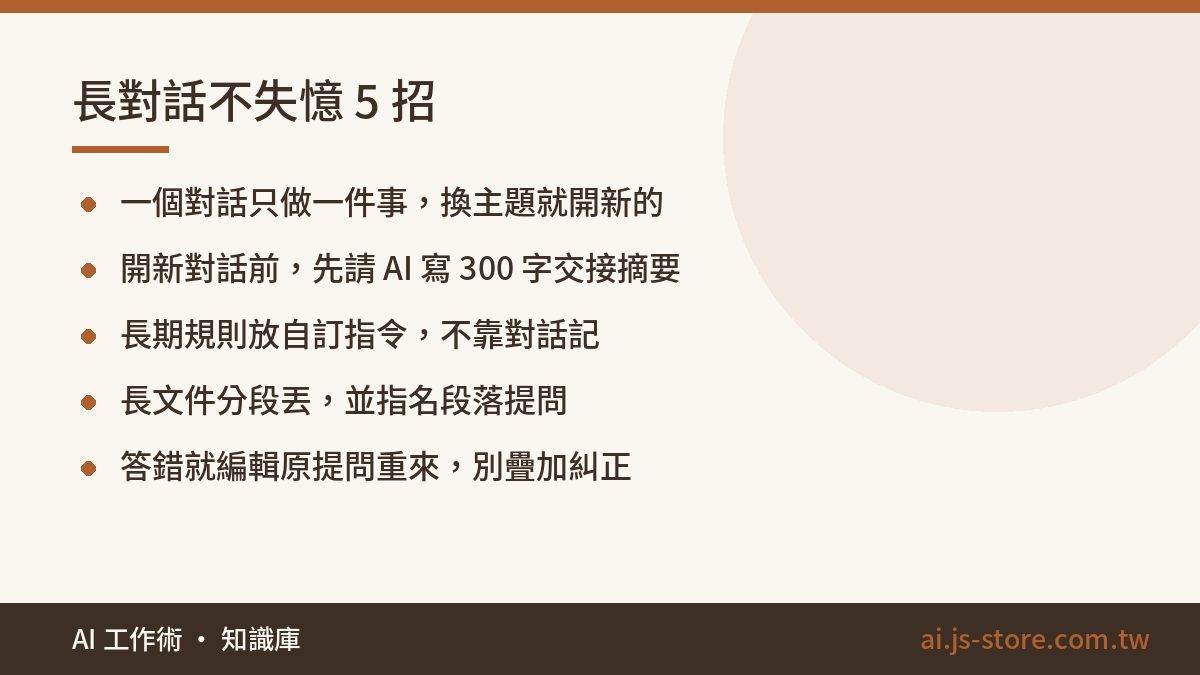
- 一個對話只做一件事:寫文案就寫文案,換成查資料就開新對話。主題混雜是上下文最大的浪費。
- 開新對話前,先請 AI 寫交接摘要:直接這樣下指令:「請把這段對話整理成交接摘要,包含目標、已確定的決定、已否決的方案與原因、待辦事項、必須遵守的格式規則,300 字以內。」把這段貼到新對話開頭,等於把重點搬到乾淨的新桌面。
- 長期規則放自訂指令,不要只在對話裡講一次:口吻、格式、禁用詞這些每次都要的東西,放進自訂指令或專案說明,每輪都會被帶上,不會被擠掉。怎麼寫才有效,可以參考自訂指令健檢 7 招。
- 長文件分段丟,並指名段落提問:與其丟一整份 80 頁的報告問「重點是什麼」,不如一章一章處理,或者明確說「只根據第 3 節回答」。
- 答錯就編輯原提問重來:在錯誤回答底下連續糾正三次,上下文裡就留著三份錯誤版本。回到出錯的那則訊息改寫後重新生成,效果通常好很多。
- 關鍵資訊放開頭或結尾:利用模型對頭尾比較敏感的特性,最重要的限制條件放在提問最後再講一次,例如「再次提醒:全文不超過 500 字」。
這 6 招裡,CP 值最高的是第 2 招。我們內部的習慣是:對話超過二、三十輪,或中途貼過兩三份長文件,就主動寫交接摘要開新的,不要等 AI 明顯變笨了才換。
上下文越長越好嗎?什麼時候才值得用
不一定。上下文長是一種能力,但不是免費的:
- 成本:如果你是串 API 做產品,每一輪都要把整段歷史重新送一次,對話越長,後面每一則就越貴。我們自己串 API 做產品時,帳單大頭常常不是 AI 的輸出,而是每輪重複送進去的歷史對話。
- 速度:要讀的東西越多,回應越慢。
- 準確度:塞進一堆無關內容,反而會干擾模型找到真正的重點。
適合用長上下文的情境:需要跨文件交叉比對(例如合約前後條款是否矛盾)、理解整個程式碼庫的結構、對整份逐字稿做總覽摘要。這些任務的答案散落在全文各處,切段反而會漏。
不建議硬塞長上下文的情境:只需要其中一小段資訊、多個主題混在一起的閒聊、需要精準引用數字的問答。這時候分段處理或先搜尋再提問,又快又準。
常見問題
Q:Context window 和 AI 的「記憶」功能一樣嗎?
不一樣。Context window 是單次對話裡 AI 能看見的全部內容,關掉對話就沒了。記憶功能是產品另外幫你存的一小份摘要筆記,開新對話時挑重點塞進去,容量小,也記不住細節。
Q:怎麼知道對話快滿了?
大多數聊天介面不會顯示剩餘容量,只能看徵兆:回覆變慢、開始忽略早期規則、重複講過的內容,或把否決過的方案又提出來。保守做法是不要等徵兆出現,對話一長就主動寫交接摘要開新的。
Q:付費版的上下文一定比較長嗎?
通常方案越高上限越大,但各家調整很頻繁,以官方規格頁為準。而且上限變大不代表中段就不會漏,分段處理與交接摘要的習慣還是一樣有用。
Q:把一整本書丟給 AI,它能全部記住嗎?
如果在上限內,它能「看到」全書,但不代表每個細節都同樣注意,中段的內容尤其容易被忽略。如果要精準問答或整理筆記,一章一章處理會可靠得多。